
少し前まで、AIが作った画像には逃げ道があった。指がおかしい。看板の文字が読めない。背景の人間が溶けている。「ほら、ここを見ればAIだ」と笑えたのである。
ところが2026年、その攻略法が急速に通用しなくなってきた。肌、金属、ガラス、照明、カメラのボケまで、それらしい。しかも怖いのは、単に絵が上手くなったことではない。中身を間違えていても、画像だけは堂々と本物らしく作れるようになってきたことだ。
わずか4年余りで、勝負する場所が変わった
2022年のDALL·E 2をOpenAIが発表した際、初代DALL·Eとの比較で、評価者の88.8%がDALL·E 2を「よりフォトリアル」と評価した。すでに当時からリアルさは重要な競争項目だった。
しかし現在は、そこだけではない。2026年9月8日に公開されたChatGPT Images 2.5では、自然な照明や質感に加え、参照画像の被写体を保ちやすくし、編集指示への追従や複数回編集での一貫性も強化された。
つまりAI画像は、「一枚のうまい絵を出す機械」から写真や広告を人間とやり取りしながら修正していく制作装置へ変わりつつある。
しかもOpenAIによれば、ChatGPT Imagesと開発者向けAPIのGPT-Image系では、現在1週間に30億枚を超える画像が作られているという。30億÷7日÷24時間÷3600秒で計算すると、毎秒およそ5000枚。OpenAI系だけの数字である。
昔のターボ車なら「最高出力が20馬力上がった」で済んだ。こちらは性能が上がったうえ、生産台数まで桁違いなのだから少々タチが悪い。
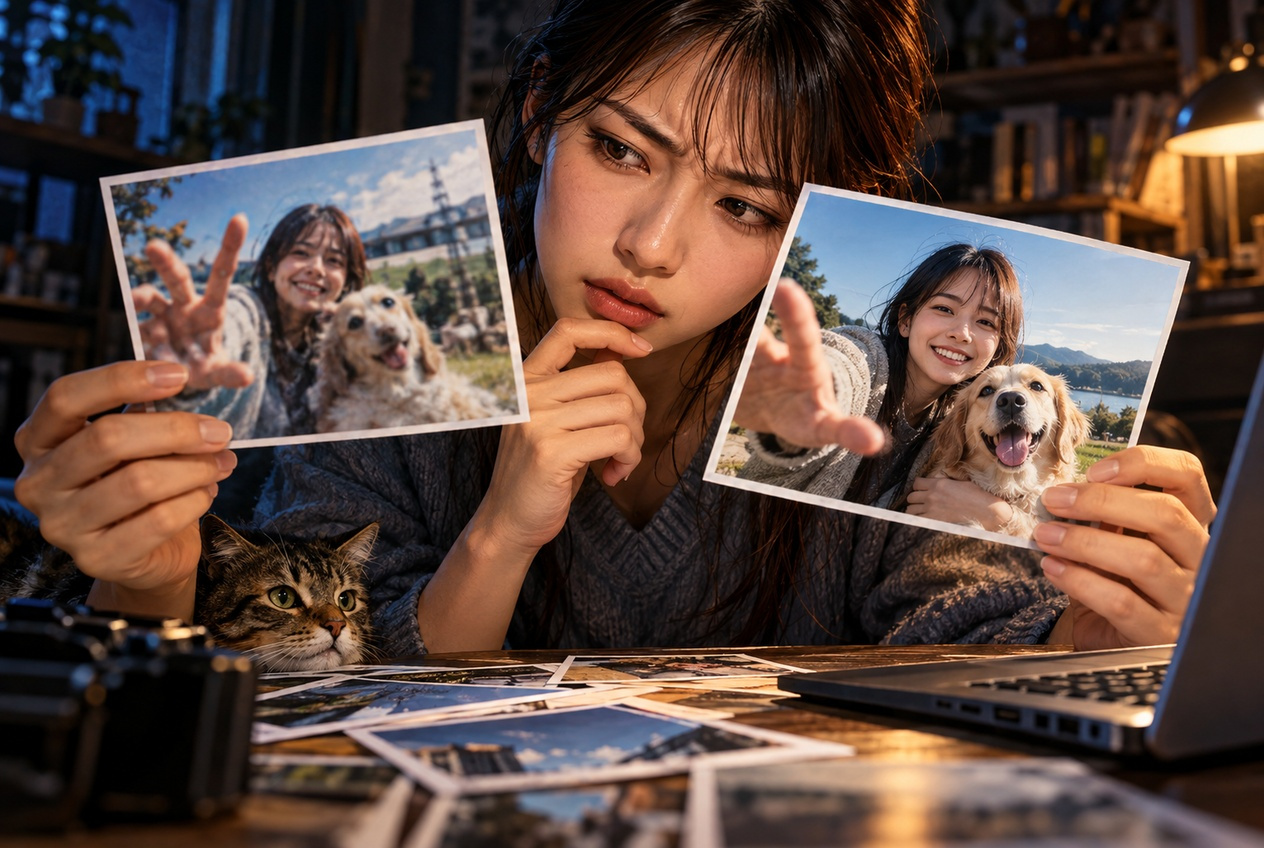
AI生成による比較イメージです。実際の2022年モデルと2026年モデルの生成結果を並べたものではありません。
さらに妙なのは、「正確さ」まで急上昇していること
2026年10月6日、Google DeepMindは画像生成モデル「Nano Banana 2.1」のモデルカードを公開した。そこで評価対象になっているのは、もう画質だけではない。人物の一貫性、商品一貫性、複数画像編集、インフォグラフィック、そして事実性まで入っている。
インフォグラフィックの事実性評価値では、比較対象のGemini 3.1 Flash Image(Thinking)の0.179に対して、Nano Banana 2.1(Thinking)は0.521。単純に数値を割ると約2.9倍になる。ただし、これはベンチマーク上の評価値の比であり、「事実が2.9倍正しくなった」という意味ではない。
では安心かというと、ここから話がおかしくなる。
Google自身が同じ資料で、小さな文字、長文、左右の位置関係、3D推論、世界知識、そして事実性にはまだ限界があり、ハルシネーションも起こり得ると明記している。
「間違いが減った」と「間違わなくなった」は、まったく違う。
しかも画像生成では、その間違いに写真並みの質感が付く。
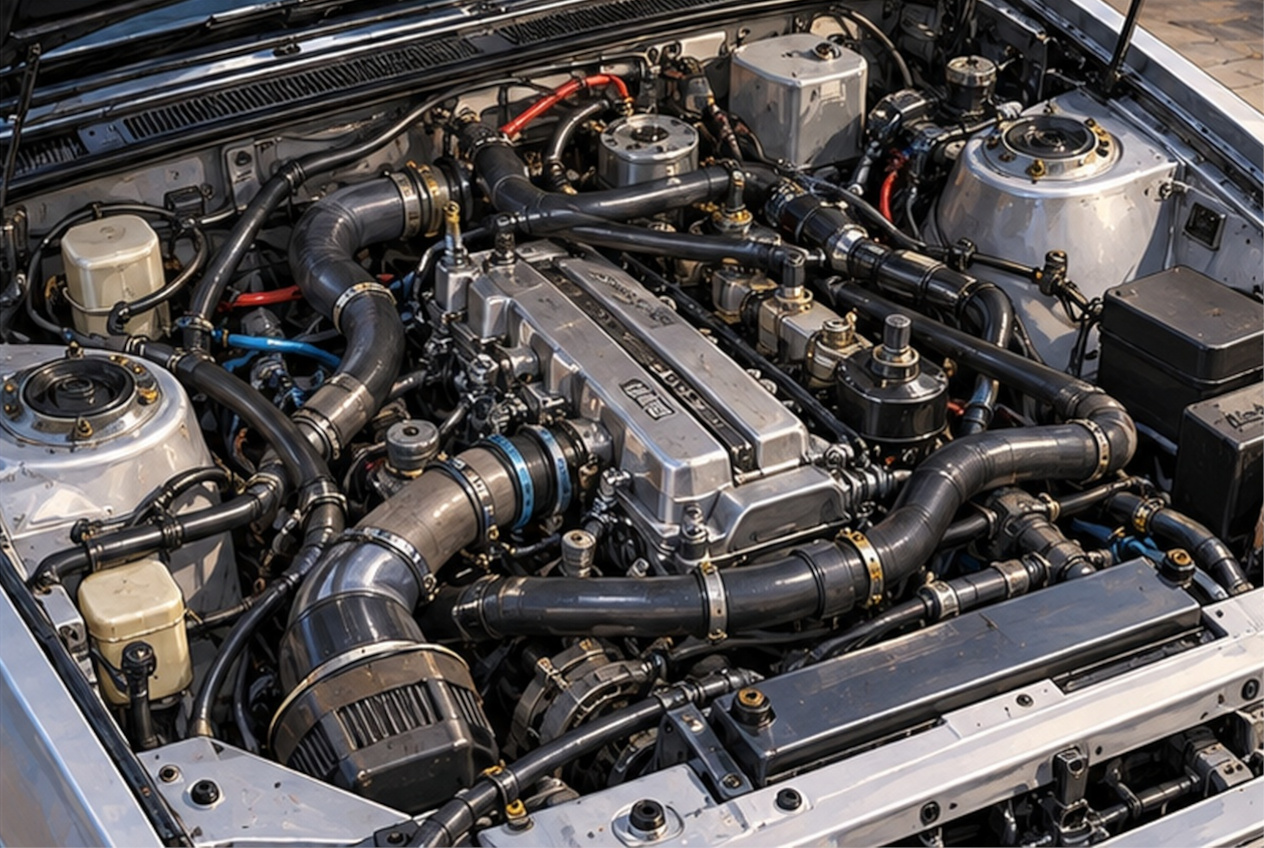
AI生成による架空のエンジンルームです。実在するメーカー・車種・エンジン構造を再現したものではありません。
人間の目なら見破れる? 研究結果はかなり嫌な数字だった
「俺なら分かる」という最後の砦も、あまり頼もしくない。
2025年に発表された1,276人対象の研究では、画像・音声・動画などを含む全刺激の平均正答率は51.2%、画像だけでは49.4%だった。特に人間の顔を含むAI画像では判定が難しくなった。
一方、Microsoft Researchが1万2500人以上、約28万7000回の画像判定を分析した研究では正答率62%だった。こちらはコイントスより上だが、裏返せば約38%は間違えたことになる。
研究条件が違うので「人間は50%しか見抜けない」と一括りにはできない。ただ、少なくとも肉眼だけで確実にAI画像を判定できる、とはもう言いにくい。
少なくとも本稿で取り上げた2研究は、2026年9~10月に登場したChatGPT Images 2.5やNano Banana 2.1より前に行われたものだ。したがって「今ならもっと見抜けない」とまでは断定できない一方、この数字を2026年秋の最新モデルにそのまま当てはめることもできない。
来歴情報や電子透かしがあれば安心……でもなかった
そこで登場するのが、C2PA標準に基づくContent Credentialsと、Google DeepMindが開発した不可視電子透かしSynthIDである。OpenAIも現在、生成画像に両方を利用している。
ただしOpenAI自身が、これらは画像の出所を判断するための手掛かりであり、その画像が正確か、未編集か、正しい文脈で使われているかを保証するものではないとしている。
C2PAのメタデータはリサイズや形式変換、スクリーンショットなどで失われる場合もあり、SynthIDなどの来歴シグナルが検出されなかったからといって「AI生成ではない」とも断定できない。
ここに、2026年のAI画像問題の妙なところがある。
「AIが作った画像か?」と「画像の内容は本当か?」は、別の質問なのだ。
昔は「間違ったAI画像」は下手だった
昔のAI画像なら、ボンネットを開けた瞬間に配管がどこにもつながっていない珍改造車みたいなものだった。何となく怪しいので、人間も警戒できた。
ところが現在は違う。
たとえば存在しない部品が、正しい金属光沢で、正しい影を落とし、正しそうな場所に取り付けられた画像が生成され得る。実在しない建物、起きていない出来事、間違った歴史風景でも同じことが起こり得る。
AI画像最大の変化は、偽物が本物になったことではないのかもしれない。
「正しい画像」と「間違った画像」の見た目の品質差が、急速になくなっている。
こちらのほうが、ずっと怖い。
ちょっと分かりにくい用語
- フォトリアル
- イラストやCGでありながら、実際にカメラで撮影した写真のように見える表現や質感のこと。
- ベンチマーク
- AIなどの性能を同じ条件で比べるための評価テストや、その評価値。数値が高くても、実際の性能が単純にその倍率だけ向上したという意味にはならない。
- ハルシネーション
- 生成AIが、実際には存在しない情報や誤った内容を、もっともらしく作ってしまう現象。画像では、存在しない物体や誤った構造を自然に描く場合がある。
- C2PA/Content Credentials
- 画像や動画がどこで作られ、どのように編集されたかという来歴情報を確認しやすくする仕組み。主にメタデータや暗号署名を利用する。
- SynthID
- Google DeepMindが開発した、AI生成コンテンツに人間の目では分かりにくい情報を埋め込む技術。生成AI由来かどうかを調べる手掛かりとして使われる。
【編集者が思うこと】
俺が怖いと思うのは、AIが間違えることそのものじゃない。人間だって間違える。
昔のAIなら、間違えた時はだいたいボロが出た。「指がおかしいぞ」「文字が変だぞ」と、こっちにも逃げ道があった。
ところが今は、間違ったものにまで新車みたいな塗装をして出してくる。しかもその性能が、数年単位どころか数か月単位で更新されている。
たぶん今後、「写真を見たから信じる」という感覚そのものを捨てなきゃいけなくなるんだろう。写真が証拠だった時代を生きてきた人間には、そこが一番気持ち悪い。
昔は「百聞は一見にしかず」と言った。でもAI時代には、その“一見”のほうを疑わなきゃならない。なんとも面倒な世の中になったものである。
参考資料
- OpenAI「DALL·E 2」 — DALL·E 1とのフォトリアリズム比較
- OpenAI「Introducing ChatGPT Images 2.5」(2026年9月8日)— 画像品質、編集一貫性、生成規模
- Google DeepMind「Nano Banana 2.1 Model Card」(2026年10月6日)— 画像生成評価、事実性、既知の限界
- Communications of the ACM「As Good as a Coin Toss: Human Detection of AI-Generated Content」(2025年)— 1,276人による合成メディア識別実験
- Microsoft Research「How good are humans at detecting AI-generated images? Learnings from an experiment」(2025年)— 1万2500人以上、約28万7000件の画像判定
- OpenAI「Advancing content provenance for a safer, more transparent AI ecosystem」 — C2PA、SynthID、画像来歴確認の仕組みと限界
- OpenAI Help Center「OpenAI生成コンテンツの来歴シグナル」 — 来歴情報が正確性・未編集・文脈を保証しないことについて